我让 Opus 5.5 当导演,一个人 2 小时跑通 AI 短剧制作全流程
Source: https://x.com/i/article/2110378794284654592
我昨天发了一期教程,讲怎么让 Opus 5.5 当 AI 导演,全程自动制作一部AI 短剧。视频 29 分钟,太长了,所以写了这篇省流版,带你快速了解这期到底在讲什么,以及它能帮你做什么。
https://x.com/zhu185178/status/2109857363314512163
在这期教程中,我制作了一集短剧叫《神文觉醒》(剧本 GPT 写的,机味儿很重,我知道,不用说了),重点是提示词我一句没写,剪辑也没动过一刀。我只做了三件事:给它剧本,回答它几个问题,看片提意见。剩下的,从写提示词、出图、生成视频,到挑片、剪辑、配乐,全是 Opus 5.5 在一个对话框里做完的。
https://x.com/zhu185178/status/2108832507030585785

《神文觉醒》第一集里的六个镜头。片名的墨迹、纸上冒火的“火”字、天上写出的“青云文院”,都是视频模型生成的,没有后期贴字。
这期教程我最想说的就一件事:Opus 5.5 太强了,强到我把自己做 AI 短剧的流程整个推倒重来。以前用画布工具,提示词自己写,镜头一个一个拼,人是操作员。后来提示词可以交给 AI 写了,可出片、挑片、剪辑还是得自己来,人还是半个操作员。现在这些事它都能做了,人只剩导演的活,定方向,看戏对不对。
光有 Opus 5.5 还不够。一部片子从剧本到成片中间几十步,它得知道先做哪步、后做哪步,每步做到什么程度才算通过。所以我把自己的工作流程升级到了分镜师 4.0,专门适配它。做一部片拆成九个环节,从发剧本、回答问题,一直到剪辑、自审、看片反馈,每个环节交出一份文档,下个环节照着这份文档往下做,上下文再长它也不会跑偏。九个环节里你只参与三个,发剧本、回答问题、看片提意见,其余六个都是它自己完成的。
视频里我拿这部片从剧本到成片走了一遍,一共讲了 16 个技巧。技巧才是这期的精华,每一个都对着 AI 短剧的一个老毛病,也都有这部片里的真实案例。下面我按制作顺序讲一遍。
开工之前你只需要准备一份剧本,再接好三类模型,出图、视频和音频。这次出图用的是 GPT Image 2.5,视频用 MiniMax H3,配音用 MiniMax 的语音模型,音乐和音效用 ElevenLabs。这些都能换成你习惯的,比如视频换成 Seedance 2.5。Opus 5.5 是导演,这些模型归它调度。
很多人拿到剧本,第一件事就是写提示词。我的第一步正好相反,先让 Opus 5.5 问我问题。我把 1500 字的剧本发过去,它先建好项目文件,然后问了我五个问题,用途、平台、画风、预算,还有质量要求。片长、声音风格这些,它直接替我定了。我回答它,横屏,真人剧,预算不设上限,其他的它来定。它把这些写进需求文档,从这一步往后就不再需要我了,直到第一版成片出来。
它问的五个问题。我答完,它记进需求文档,说一句从这里到交片不再问我。
接下来我会介绍 16 个技巧,但这 16 个技巧其实也是 Opus 5.5 自动完成的,我只是把用到的技巧告诉你。这样的话,在你自己搭建 harness,或者发现它哪里做得不对的时候,你会知道问题出在哪里
第一个技巧,先把需求问清楚,再开始制作。它只问剧本里看不出来的事,剧本里写了的一个都不问,所以剧本和拍摄描述写得越细,它问得越少,越省时间。
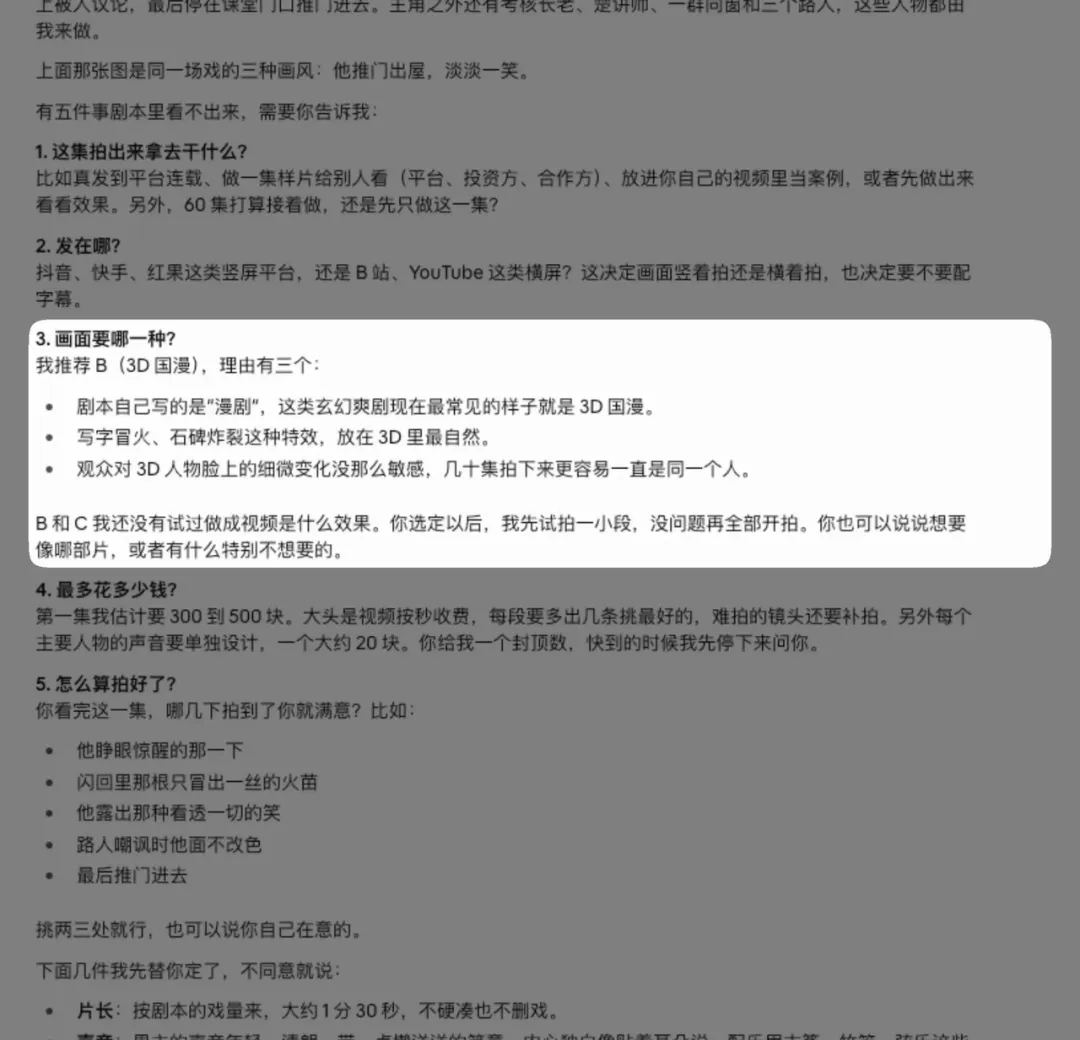
第二个技巧,画风别只靠文字描述,先出样图再定。问问题之前,它先用剧本里同一场戏生成了三张样图,真人古装剧、3D 国漫、2D 国风动画。你说要电影感、要高级,它理解的可能和你想的完全不一样,三张图摆在一起,一眼就能定。它推荐 3D 国漫,理由是写字冒火这种特效放在 3D 里更自然,几十集拍下来人物也更容易保持一致。我最后选了真人。它会给建议,也讲得出理由,但拍板的是你。你有没有审美、懂不懂业务,在这一步就显出来了。

同一场戏的三种画风。
剧本发过去以后,它没有马上写提示词,先生成了三份文档。第一份是剧本定稿,台词一个字不改,只改拍摄方式,比如原剧本里“神文基础课”只有一行字,它改成门楣上方五个金字一笔一笔浮现出来。第二份是分段表,第三份是连戏表。后面三个技巧都在这两张表里。
第三个技巧,按段生成,别一个镜头一个镜头生成。整集分成 16 段,一段就是一次生成,一段里可以放两三个镜头,带切换时间。一段里的几个镜头是一次生成出来的,人物和场景天然对得上。每多一次独立生成,就多一道可能接不上的缝。这张分段表之后也是整部片的进度表,每段生成了几条候选、选了哪条、过没过审,都记在上面。

分段表就是进度表。每段选了哪条候选、为什么选,写在生成那一格里。
第四个技巧,把最容易穿帮的细节提前锁定。这就是连戏表管的事。AI 视频很容易前后不一致,连戏表把容易穿帮的细节提前锁定在一张表里,人物的辨识特征,道具在每场戏里的状态,谁站在哪、朝哪边看,画面里出现的每一个字,还有时间和天气。头天夜里下过雨,第二天早上地面就得是湿的。这部片里有一处穿帮正好说明它的用处。主道那场的两个路人,上一个镜头甲在左、乙在右,补拍的镜头站反了。原因是连戏表里只写了两人站在石灯旁,没写谁左谁右。它在提示词里写明甲在画面左边、乙在画面右边重新生成,再把站位补进连戏表。表上没写的,模型就随便来。

第五个技巧,一条好的视频提示词,写清五件事。拿起床这场戏举例。剧本里只有一句话,林书白猛然睁眼,额头冷汗直冒。到了提示词里,它写了镜头怎么拍,这一段安排了三个镜头,大特写猛地睁眼,中景一下坐起来,近景看着自己的手不敢相信。然后是每个镜头从第几秒开始。这一刻怎么演,眼神、呼吸、脸上的细微变化。环境声,窗缝里的风,远处的鸡叫,他急促的呼吸。最后是限制条件,这段不许出现什么,比如皮肤不要油光,画面里不要出现文字。像这样的视频提示词全片 41 条,加上 44 条文生图提示词,一共 85 条,全是它写的。我写的只有那 1500 字剧本。

一句剧本变成一次生成。这条提示词写得很专业,但里面埋着三个问题,后面会一个一个讲到。
有了分段表,下一步是备素材。素材库里放的是这部片的设计资产,人物、场景和声音,每一样都是它读完剧本以后自己设计、自己生成、自己检查的。
第六个技巧,每个角色一套三视图,外加一个辨识特征。角色一致性是 AI 短剧最大的痛点,同一个人换个镜头就可能换一张脸。所以全片 8 个角色,每人都有胸像特写、全身正面和全身侧面三张图。这三张要在一张图里一次生成,再裁成单张,一次生成出来的三张,比分三次生成更像同一个人。生成视频的时候,这些单张就作为参考图输入,锁定角色的脸和服装。辨识特征是另一件事,林书白右眼下有一颗痣,袖子上有块补丁,同窗左眉一道细疤。加这个特征,是给后面认脸用的。镜头一多,每个镜头里是不是同一个人,就拿它来核对。

林书白的三视图,一张图里一次生成,再裁开用。

《神文觉醒》的演员表,每人一个辨识特征。十岁的林书白是拿二十岁的三视图当参考生成的,第一版像个少年,它在提示词里写明“是小男孩,不是少年”,头大身子小,脸上有婴儿肥,那颗痣也点名保留,改完一眼能看出是同一个人小时候的样子。
声音也是设计资产。每个角色的音色都是用一段文字描述设计出来的,年龄、身份、语速、性格都写进去,最后统一加一句“像电影同期声,不是播音腔”。
第七个技巧,想要真人质感,要写明不要什么。GPT Image 2.5 很容易生成油亮、磨皮的网红脸,你不在提示词里明确写不要,它就会一直这样生成。所以这部片每一条文生图提示词的开头,都固定有一段写实要求,皮肤要哑光、看得见毛孔,不要磨皮,不要油光。下面是我之前测试的两张图,左边提示词里没加这段,皮肤油亮,像开了美颜;右边加了,皮肤就是哑光的。

素材齐了就开拍。开拍之前先要选对生成方式。MiniMax H3 有三种生成方式,这次用到两种,同一次生成只能选一种。有台词、有人脸的戏用参考生视频,就是把人物参考图和参考音频一起输入,让模型照着生成,脸和声音一起锁住。要把画面卡准的镜头用首尾帧,在这部片里就是“火”字、片名、天上的字、门前的金字,还有推门和门外的背影。
第八个技巧,画面里的字,用首尾帧来写。画面里出现文字是 AI 视频的老问题。H3 这一代已经能直接生成文字了,但这部片里只靠提示词描述的那一版金字,生成出来还是假字。片名“神文觉醒”四个字一笔没错,靠的是首尾帧。先用文生图模型生成两张图,一张没有字的首帧,一张带字的尾帧,每一笔都核对过。视频模型只负责生成中间的过程,墨迹一笔一笔出现,最后停在和尾帧一样的画面上。用这个办法生成的六条,定格的字全部正确。门楣上浮现的“神文基础课”,天上出现的“青云文院”,都是这么生成的。这个办法是它自己想出来的,它先查了模型的官方文档,确认支持首帧加尾帧,然后设计了这个方案。

左边是视频模型生成的首尾两帧,右边是文生图模型生成的首帧和尾帧。
第九个技巧,也是这期我最想让你记住的一个,提示词里出现什么,画面里就可能有什么。还记得起床那条提示词里的三个问题吗,两个都在这里。它给每个人物都套了一句固定写法,脸、发型、眼镜都要和参考一致。可林书白根本不戴眼镜,结果主道那场的一条候选里,模型真给他生成了一副圆眼镜。眼镜只是顺手带进去的一个词,模型就当真了。这一条它挑片的时候自己查出来,直接废掉,那句固定写法也改成了参考里没有的东西一律不加。

另一个是“冷汗”。剧本里那句额头冷汗直冒,“冷汗”两个字被写进了提示词,盖过了限制条件里的“不要油光”,脸就发油了。这一处是我看片的时候标出来的,它把“冷汗”删掉,表演改成抿着嘴,像在默默忍着头疼。我只标了这一个镜头,它把全片的近景脸都查了一遍,开头睁眼那一镜也发亮,一起换掉了。所以写进提示词的每个词,都要对着这部片的人物和这场戏核一遍,不要的东西别顺手带进去。

第十个技巧,挑片要有标准。同一段往往要生成好几条,再一条条看,这是 AI 短剧最耗人的环节之一,这部片的挑片全是它自己做的。每一段它一般先生成 3 条候选,先看硬指标,脸像不像、台词对不对、音量合不合适、有没有画面崩坏。都过了,最后按表演选。它没有原生读视频的能力,审核靠抽帧,抽帧看画面,比对人脸,把台词听写出来核对。抽得太稀,动作一快,变形就漏过去了,所以有动作的那几秒它会抽得更密。这样查出来的问题,比如从半蹲站起来时画面跳帧,切镜头之后屋里的陈设换了位置,走远的人背上有一块斑块忽隐忽现。

在 Studio 里点开片名那一段,右栏是生成了几条候选、选中了哪条、发给模型的提示词和参考,还有首帧和尾帧。

起身那一段三条候选的密集抽帧。腿和被子有没有搅在一起,只在连续帧里看得出来。
第十一个技巧,语气靠表演状态,不靠参考音频。有台词的戏最常被吐槽的就是说话机械、表情僵硬。这部片最早生成的那批台词就是这样,原因有两个。一个是输入的参考音频用的是语音模型合成的一段闲聊,视频模型不只学音色,连语气和节奏也一起学了,参考音频没有起伏,台词也就没有起伏。另一个是一句台词怎么念,取决于人物这一刻的表演状态,可原来的提示词里没写清楚。改法是每句台词前面写清这一刻人物的表演状态,比如同窗嘲笑他那句,写的是扯着嗓子边笑边喊,喊到“青云之耻”笑破了音。提示词里还明确告诉模型,参考音频只管音色,语气全听表演的。参考音频本身,也按每句的情绪来生成。两种做法生成出来的台词差多少,文章里听不到,你去视频里听一下就明白了。

同一句台词,改前改后的提示词。改后多出来的是这一刻怎么演,还有一句参考音频只管音色。
第十二个技巧,能在剪辑里修的,就别花钱重新生成。成片剪出来以后它自己又复查了一遍。有一处剪辑点多出了两帧闪帧,还有一处路人凭空出现,它调整入点和出点就避开了。苦修那个镜头,前景的纸上写着一堆假字,它用数码推近把假字裁到画面外。最后一版也没花钱,结尾太急,它翻出早就生成但没用上的素材,把门外的远景延长,金光放完再淡出到黑场。这些都不用重新生成。

到这一步才轮到我出场。技术上的问题它自己能查出大部分,但一场戏演得对不对,得靠人来判断。看片我用的是 Studio,这是我做的一个插件,很新,值得单独说一说。以前它生成的素材、视频片段,我得回到项目文件夹里一个个点开看,很不方便。现在在对话框里输入 /studio,点一下 Open,它就在 Claude Code 的内置浏览器里打开,开在对话旁边。中间是播放器和分轨时间线,右栏是它交片时写的自审报告,哪里有问题、它是怎么处理的,都写在里面。空格播放,左右键逐帧,顶部可以切两个版本并排对照。进度表、素材库、每一段的候选和证据也都在这里,不用再回文件夹里找。

Studio 开在对话旁边。中间是播放器和分轨时间线,右栏是它写的自审。
第十三个技巧,提意见只说你看到了什么,不用说怎么改。看到不对的那一帧按 M 打个标记,写一句话,截帧和时间码一起存进项目。我在第二版看到主角笑的那一帧,写的是人物和背景像在两个图层。回到开头惊醒到起床这一段,又写了一句切得太碎,看着出戏。写完跟它说一声,它逐条读我的标记和截图,先确认是哪两个画面,再列修改方案,然后才重新生成。原因和改法让它去想,你只负责说现象。它量得出崩坏,量不出节奏平、过渡生硬、收尾太急,这些只有你能看出来,也是我五轮意见里提得最多的。

我在第二版 0:51 那一帧写的标记。

改完的版本和上一版可以并排放着看。
第十四个技巧,大动作单独一段,给够时间。这是起床那条提示词里的第一个问题。8 秒里安排了三个镜头,留给起身的时间太短,模型来不及生成完整的动作,画面就变形了。它当时的处理是用一个跳切把起身那一下跳过去,看片的时候我没让它过。它最后把起身单独拆成一段,一镜到底,给起身留足时间,镜头始终只拍胸部以上,腿和被子都不进画。这次用的 H3,动作一大就容易变形,所以大动作要单独一段,给够时间,容易崩的部位尽量不进画。

第十五个技巧,近景不加场景参考图。两个图层那一帧,原因是 H3 把场景参考图当成了背景板,直接贴在了人物身后,看起来像抠像贴上去的。它的修改方案是近景不加场景参考图,背景用文字描述,再做虚化,让人物和背景在同一个光线里。人离镜头越近,背景越应该虚,加一张清晰的场景图反而假。

左边是修改前,右边是修改后。
这部片我一共看了五轮,它改到第六版定稿,从发剧本到定稿前后不到一天。回忆那一段我只提了方向,色调要一眼看得出是回忆,再用快切做出记忆碎片的节奏感,具体怎么调色、怎么剪,降饱和度、偏暖、加颗粒,碎片快切每一下带一个闪白,都是它自己定的。主角的内心独白是我让它改成对口型的,画外音念出来偏平,人物自己开口说出来,力度一下就有了。结尾改了三版,最后那版就是前面说的延长远景,一分钱没花。结尾不能太急,要给观众留一点回味的时间。
最后说钱,这也是第十六个技巧,看整部片的成本,别只看单价。这部片一共花了 106 美元,文生图和配乐用的是订阅,没算在里面。很多人选 MiniMax H3 是因为便宜,单看价格确实便宜,差不多是 Seedance 2.5 的三分之一。但整部片算下来,它反而比 Seedance 贵。原因是它的能力弱一些,近景、半身、简单的推拉摇移没问题,动作一大就容易崩脸、崩身体,所以每一段都要多生成几条才挑得出一条能用的。整部片一共生成了 96 条,最后用上 27 条,生成的视频总时长是成片的 6 倍,算到每一秒成片上就比 Seedance 贵了。我自己用 Seedance 2.5,只要表达清楚,基本一次就能过,而这期的提示词全是 Opus 5.5 写的,不存在表达不清楚的问题。便宜的模型,贵在重抽。

以前用 AI 做短剧,就算提示词能交给 AI,出片、挑片、剪辑还是得自己来,因为以前的模型做不到。现在 Opus 5.5 做到了,从提示词到成片都可以交给它,你只需要判断戏好不好。这 16 个技巧视频最后整理成了一张图,可以截图保存,搭自己的 harness 时也能拿来对照。这套流程我叫它分镜师 4.0,它本身是什么、怎么装、怎么换模型,站内另有一篇文章专门讲。
最后
....
请允许我打个广告,创作不易
🌟 以上,如果你觉得内容还不错的话,辛苦随手点赞、推荐以及转发吧。也欢迎订阅废才俱乐部 www.feicaiclub.cn ,这对我们是特别大的肯定和支持!